 Correo Electrónico
 DNINFOA - SIA
 Bibliotecas
 Convocatorias
 Identidad U.N.


Elaborado por: María Fernanda Acero, Carlos Alberto Galindo
Introducción
¿Qué es Data Science?
Es la ciencia que estudia la extracción de conocimiento a partir de los datos. Data science es el procedimiento de obtener información valiosa de los datos y está apareciendo debido a la necesidad de trabajar con conjuntos inmensos de datos (conocidos como Big data), formados tanto por datos estructurados como por datos semiestructurados o desestructurados. Estos conjuntos proceden de los datos generados por los dispositivos electrónicos, las redes sociales y la web.
¿Qué proceso sigue un Data scientist?
El proceso que debe seguir un Data Scientist se puede resumir en 5 pasos:
- Extraer los datos, independientemente de su fuente (webs, csv, logs, apios, etc.) y de su volumen (Big Data o Small Data).
- Limpiar los datos, para eliminar lo que distorsiona las mismas.
- Procesar los datos usando diferentes métodos estadísticos (inferencia estadística, modelos de regresión, pruebas de hipótesis, etc.).
- Diseñar nuevos tests o experimentos en caso necesario.
- Visualizar y presentar gráficamente los datos.
Actividades Data Scientist
- Extracción datos:
Los datos se pueden extraer de diferentes fuentes, desde las más usuales como son las bases de datos que usualmente encontramos en internet, que serían llamados datos estructurados, como otras que podrían ser correos electrónicos, que son los datos no estructurados.
Los datos estructurados, son los que usualmente se observan en términos de filas y columnas con títulos, los cuales pueden ser ordenados y procesados fácilmente por todas las herramientas para el análisis de los datos. Esto se podría ver como un archivador perfectamente organizado donde todo se encuentra bien identificado y de fácil acceso.
Mientras que los datos no estructurados son aquellos que su contenido no se encuentra ordenado y no es posible identificar una estructura al verlos, por ejemplo los correos electrónicos, archivos PDF, hojas de cálculo, imágenes digitales, vídeos, audio, publicaciones en medios sociales. Los cuales podemos observar algo de información pero no se encuentra claramente toda la información de allí estructurada. La mayoría de la información que encontramos es no estructurada, ya que nos puede aportar mucho, pero no podríamos clasificarla fácilmente.
- Limpieza de los datos:
La limpieza de los datos, es uno de los procesos dentro del análisis exploratorio de datos. En cual queremos mostrar solo los datos que necesitemos y poder organizarlos de la forma en que deseamos. Por ejemplo, si encontramos valores faltantes, o valores extremos, necesitamos saber cuál sería la mejor forma de tratarlos por medio del análisis exploratorio de datos.
- Procesar los datos usando diferentes métodos estadísticos y diseñar nuevos tests o experimentos en caso necesario.
Esta actividad es la que está relacionada con el modelamiento de los datos. Es cuando realizamos diferentes métodos estadísticos, como por ejemplo la regresión lineal o las series de tiempo para poder así observar el comportamiento de las diferentes variables.
- Visualizar y presentar gráficamente los datos
Es realización de todos los gráficos y la forma de presentar el estudio. Esto se realiza por medio de los informes y los gráficos de los datos que fueron modelados y arreglados para el análisis.
¿Para qué sirve en economía el Data Science?
En la economía la ciencia de los datos ayuda a conocer las necesidades de los individuos y la situación en la que se encuentra el mercado. En un sector en concreto puede haber infinidad de empresas que compiten y conocer tanto las necesidades de los clientes potenciales como las características de las mismas, ayuda a que la empresa centre sus fuerzas en satisfacer esa necesidad. Como consecuencia, surgirán productos que verdaderamente satisfacen esa demanda, llevando al éxito de las empresas. Así mismo, se pueden obtener señales que ayuden a tomar decisiones de política económica.
Data Science aplicando RStudio
Por medio de la Ciencia de datos se puede seguir el siguiente proceso:
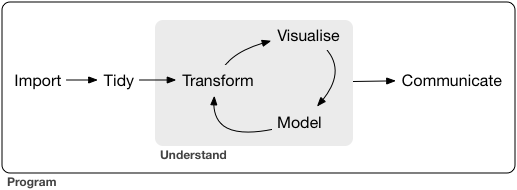
Este proceso será seguido en R por medio de un grupo de paquetes que es llamado tidyverse, con el cual será posible desarrollar todo este proceso. Estos paquetes son los siguientes:
 Tomado de: https://tonmcg.github.io/spatial-analysis/satRdays/index.html
Importar datos
La importación de los datos será realizada por medio del paquete de readr, con el cual se cargarán las bases de datos y estos serán transformados de un archivo plano a data frames:
- read_csv( ): lee archivos de extensión csv que se encuentran delimitado por algún carácter.
- reaf_fwf( ): lee archivos con un ancho fijo. Por ejemplo que las columnas estén separadas por un espacio.
- read_log( ): lee los archivos de registro común (historiales de los sucedido de algún evento).
Todas las rutinas para leer los datos tienen similar sintaxis. Luego, basta con entender una y las demás funcionan de manera análoga:

Por lo general, la primera línea de datos son el nombre de las variables y por ello, la función pone el nombre de las variables con el primer dato por defecto. Recordando que tener datos faltantes en la base es un problema, se puede especificar el valor que se quiera para todos los datos faltantes, así:

Es importante resaltar la razón por la que no se usa la función tradicional de R para leer archivos csv que es: read.csv( ). Las razones son: el comando explicado es más rápido que el tradicional, estos producen tibbles directamente y son más reproducibles (compatibles con otros equipos).
Existen otros tipos de formatos de bases de datos, en R se usan los siguientes paquetes:
- Haven: lee archivos de SPSS, STATA y SAS.
- Readxl: lee archivos de excel.
Ordenar datos
Por medio del paquete tidyr, el cual proporciona gran diversidad de herramientas para ayudar a ordenar los conjuntos de datos desordenados. Para poder determinar si el conjunto de datos están ordenados, existen 3 reglas
- Cada variable debe tener su propia columna.
- Cada observación debe tener su propia fila.
- Cada valor debe tener su propia celda.

Los datos generalmente se organizan para hacer más sencillo el análisis de los mismos. Por ello, es importante tener presente cuáles son las variables. Existen diferentes manera de visualizar las bases de datos, por lo que R ofrece algunas herramientas para transformarlos:
- gathering( ): se usa para cambiar el orden de las columnas, ya que puede que no sean las variables. Aquí se puede ver un ejemplo:


- spread( ): se usa cuando una observación está dispersa en varias filas.
Se puede concluir, que existen varias formas de organizar los datos, pero algunas se pueden ver visualmente más ordenadas y puede hacer más fácil su interpretación.


- Separate( ): sirve para separar columnas con algún carácter en común que se usa como separador. La función separa por defecto con caracteres especiales o no alfanuméricos.

- Unite( ): es el inverso de la función separate( ), ya que une dos o más columnas.


Transformar datos
Con dplyr se puede transformar los datos de acuerdo a las necesidades de la siguiente manera:
- Filtrar algunas observaciones específicas: se usa la función filter( ). El primer argumento de la función es el nombre del data frame y el segundo es la característica a filtrar. Los siguientes son los operadores comparativos y lógicos en R:

Un problema importante en R, es cuando aparecen errores faltantes. Ya que muchas operaciones con errores faltantes no se realizan de manera correcta. Luego, es indispensable tener clara la existencia de los mismos.
- Reordenar las filas: para ello se usa el comando arrange( ). Toma un data frame y lo reordena respecto a las columnas.
- Seleccionar toda una variable a estudiar: para seleccionar un subconjunto de variables de una base de datos enorme se usa el comando select( ).
- Crear nuevas variables con alguna transformación: por medio del comando mutate( ) se pueden agregar nuevas variables al final de la base de datos.
- Extraer muchos datos con sus características principales: el comando que se usa es summarize( ). Lo que se obtiene con el comando, son algunas características importantes de un conjunto de datos.
- Desagrupar datos: se usa para la desagregación de los datos. El comando en R es ungroup( ).
Visualizar datos
Los gráficos se pueden realizar por medio de la función de ggplot2, por medio de esto se desea especificar de forma dependiente cada uno de los bloques de código que se usarán para realizar los gráficos. Estos bloques son los siguientes:
- data (datos)
- aesthetic mapping (mapeo estético)
- geometric object (objeto geométrico)
- statistical transformations (transformaciones estadísticas)
- scales (escalas)
- coordinate system (sistema coordinado)
- position adjustments (ajustes de posición)
- faceting
Para poder realizar los gráficos se usará la base de datos que se encuentra dentro del paquete de ggplot2, el cual es llamado mpg. Con esta, un gráfico de dispersión se puede realizar de la siguiente forma:


Donde en el bloque de ggplot() elegimos la base de datos y por medio de geom_point() realizamos el gráfico de dispersión. Dentro de la función aes(), podemos ubicar los aesthetic mappings, con lo que determinamos cómo se observarán los datos. Es posible añadir más aesthetic mapping, como se puede observar acá:


Por otro lado, en ggplot2 es posible realizar facets, los cuales pueden ser facet_wrap() y facet_grid(), con lo que realizamos el mismo gráfico de una o dos variables con respecto a una variable cualitativa(wrap) o dos variables cualitativas (grid). Por ejemplo, realizar el histograma de frecuencias de las edades de un grupo de estudiantes para el género femenino y el masculino. Por ejemplo, tomando la base de datos de mpg y realizando un gráfico de dispersión para las variables displ y hwy, realizando el facet_wrao para la variable class se tiene que:


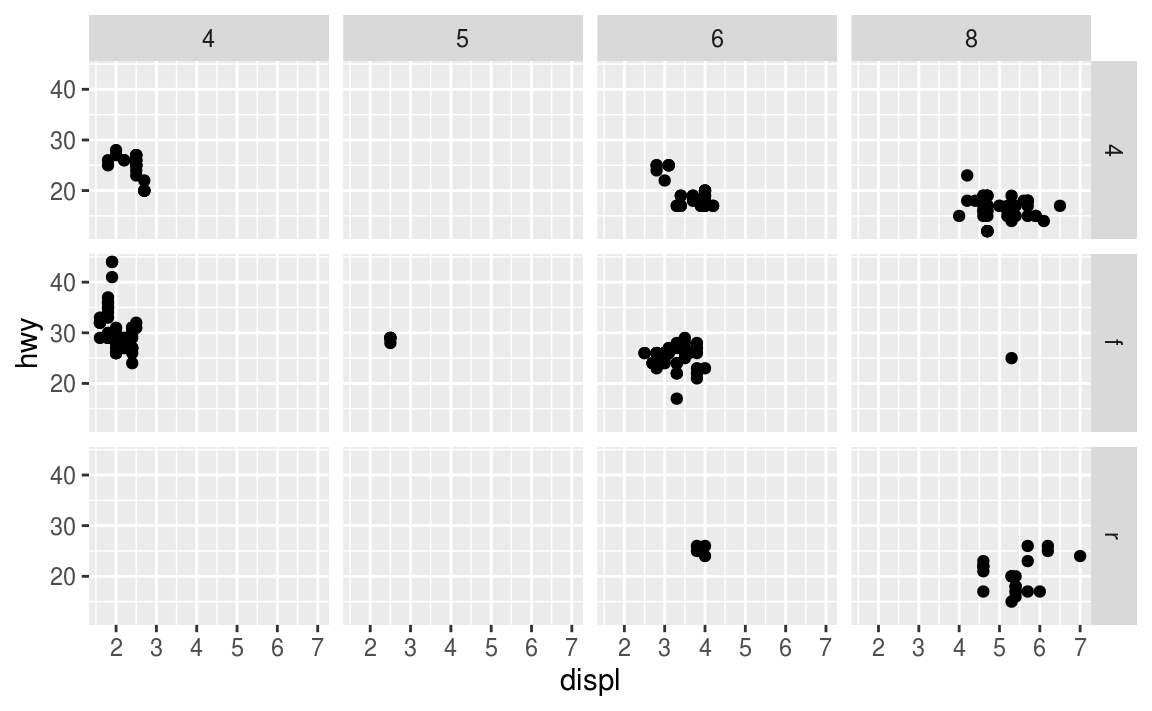
Ahora, se realiza el facet_grid(), tomando las variables drv y cyl para el facet:

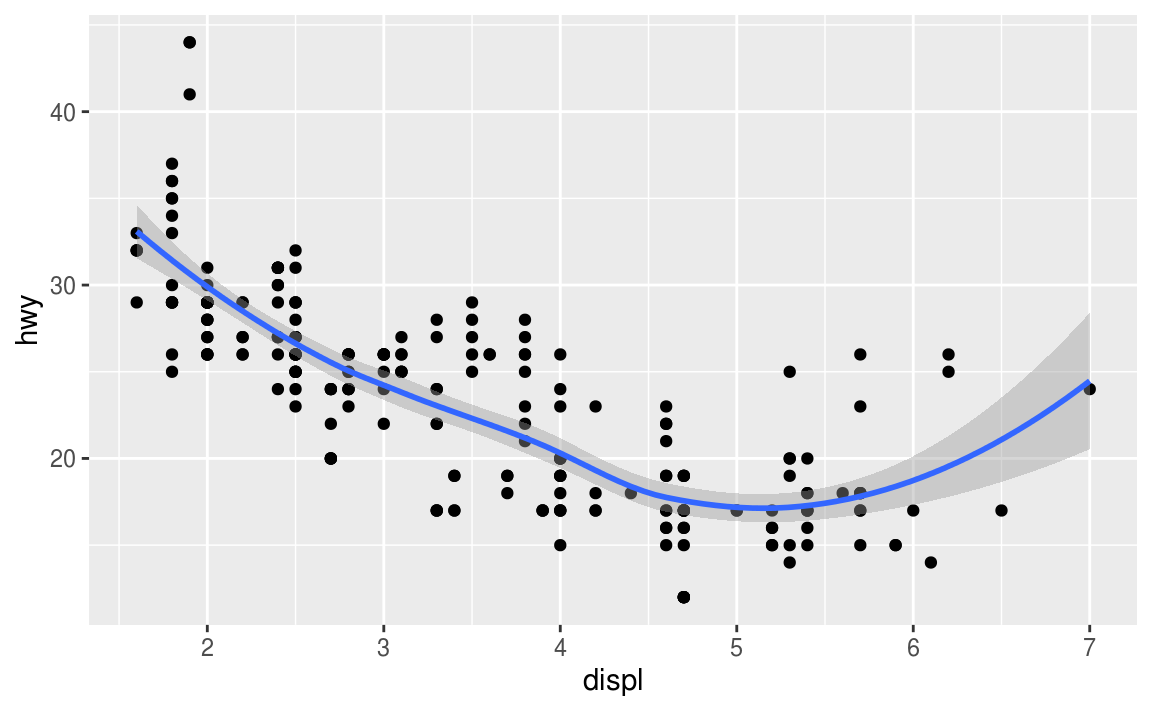
Por otro lado, se pueden agregar diferentes objetos geométricos al gráfico, esto se hará separando cada uno de los bloques de forma independiente y uniéndolos por medio del símbolo '+', como se observa acá:

Modelar
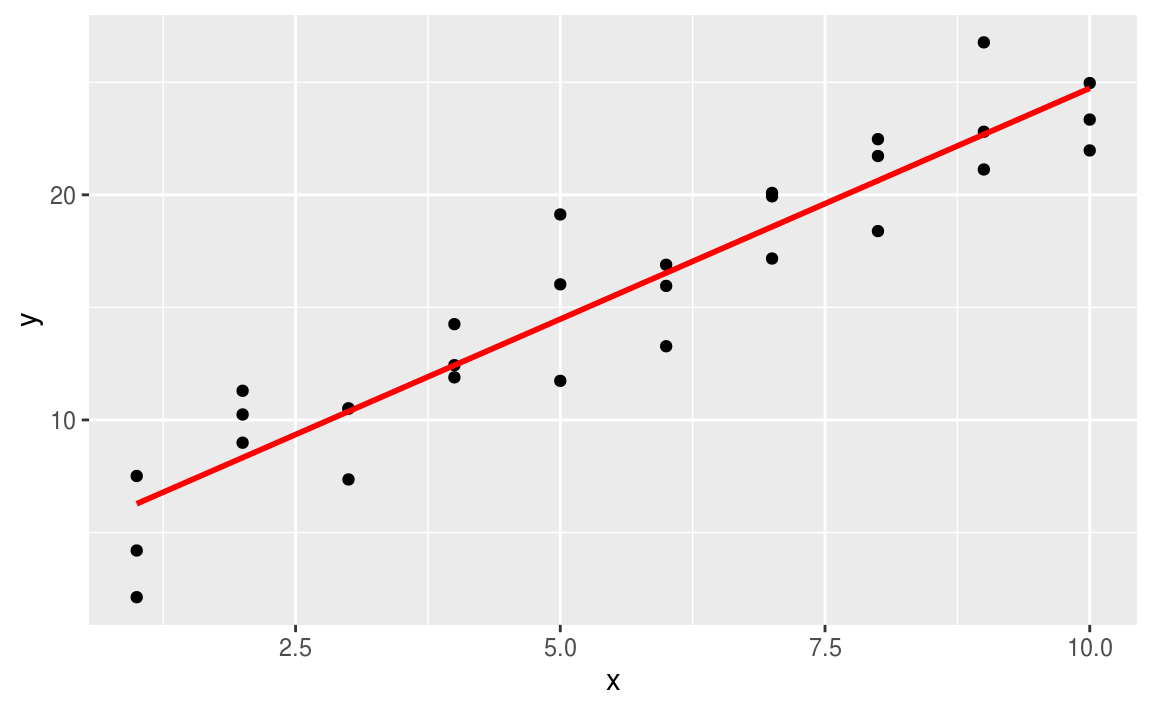
Para realizar el modelamiento de los datos se puede realizar por medio del paquete modelr. Por medio de este paquete podríamos realizar las predicciones de los datos y luego graficarlas. Para esto, primero se generará la malla para los datos:

Luego, a partir de esta malla, se generan unas predicciones:

Para luego, poder graficar cada uno de los puntos y luego realizar la linea de predicción a partir de estos datos:

Por otro lado, es importar ver el comportamiento de los residuos de un modelo, esto se puede observar agregando los residuos a los datos inicialmente:

Luego, se realizará el polígono de frecuencias de esto por medio de la función geom_freqpoly()

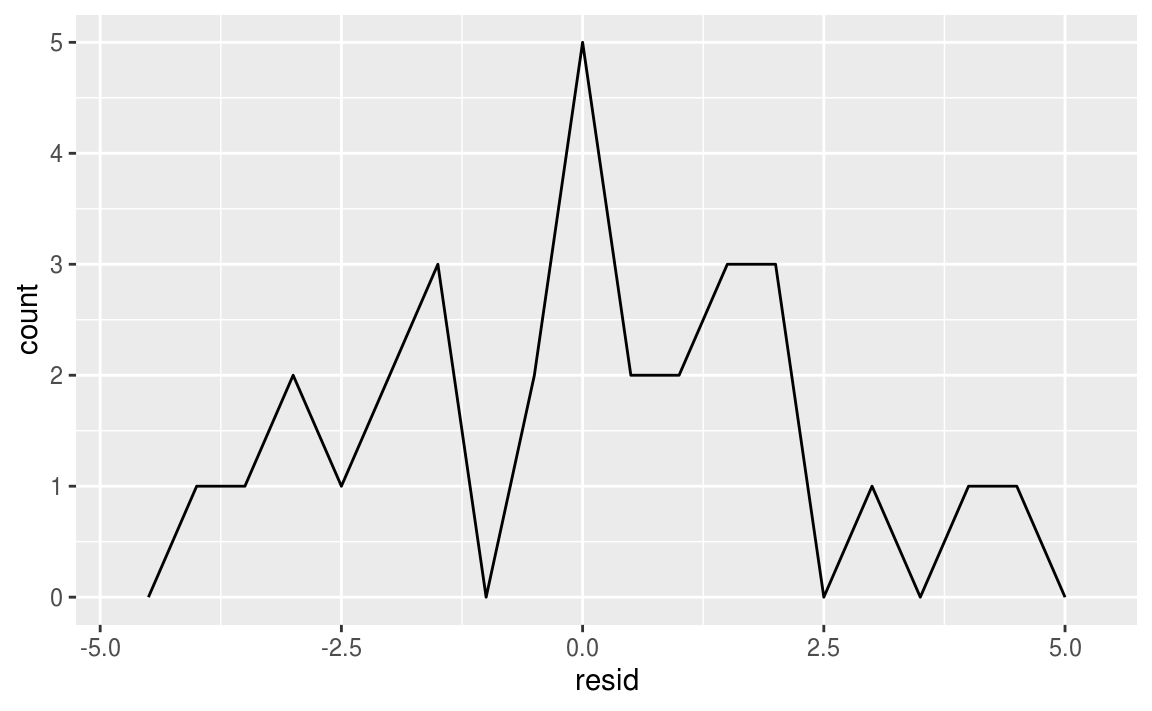
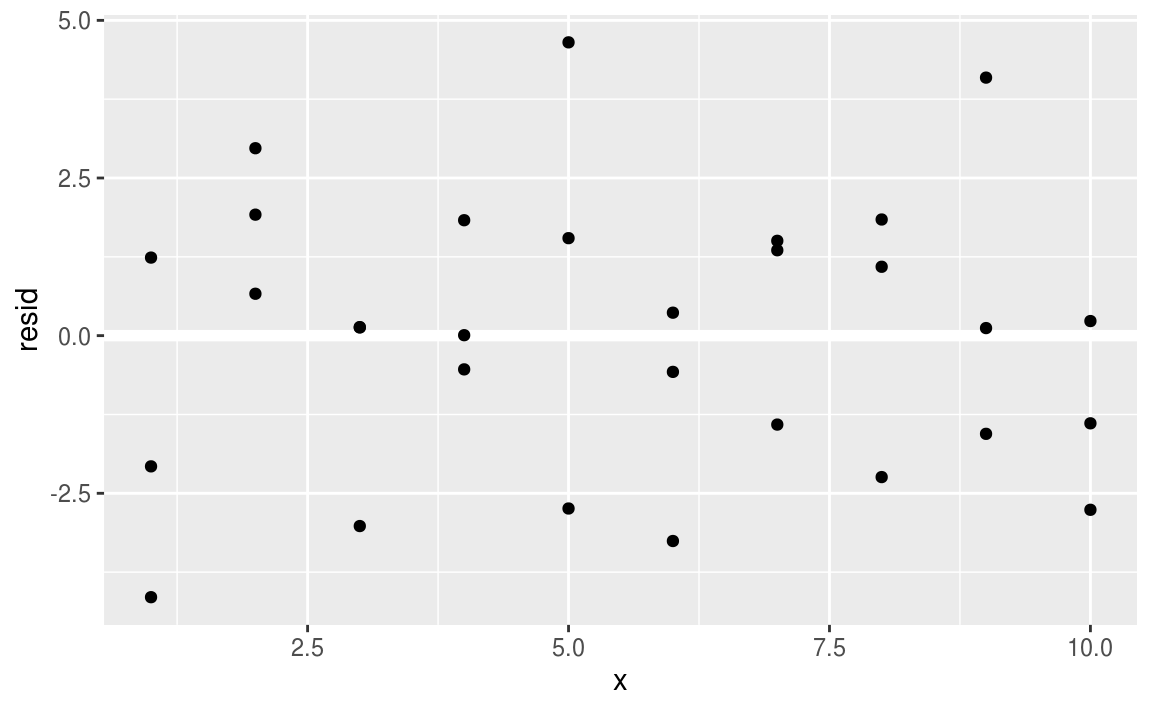
Con lo cual, podemos observar que en general los residuos se encuentran al rededor de cero, lo cual nos indicaría que se cumplen los supuestos del modelo. Además, es posible realiza un gráfico de dispersión de los valores de x con respecto a los residuos con lo cual podremos observar si existe algún tipo de comportamiento. Pero como podemos observar no existe ningún comportamiento, lo cual nos indicaría que el modelo se está ajustando correctamente.

Comunicar
Se pueden realizar diferentes informes en R Studio por medio de R Markdown, el cual provee un ambiente de trabajo unificado, donde se pueden realizar diferentes tipos de documentos, desde PDFs, archivos de Word, diapositivas y más. Este está diseñado para ser usado de tres formas:
- Para comunicar los resultados, teniendo en cuenta más que el código
- Para colaborar con otros científicos de datos que pueden estar interesados en lo que se realiza, y puedan trabajar con ello (el código)
- Como un ambiente en el cual se puede trabajar la ciencia de datos. Este recurso integra un gran número de diferentes paquetes de R y herramientas externas. Luego, en este caso no es tan fácil encontrar la información por medio de ?.
Para poder conocer todas las funcionalidades de R Markdown se puede revisar las “Cheat sheet”, con las cuales se puede obtener las herramientas básicas para trabajar con esto:
- La hoja de “trampa” de R Markdown https://www.rstudio.com/wp-content/uploads/2015/02/rmarkdown-cheatsheet.pdf
- La hoja de referencia de R Markdown https://www.rstudio.com/wp-content/uploads/2015/03/rmarkdown-reference.pdf
Referencias
- Wickham, Hadley, and Garrett Grolemund. 2017. R for Data Science: Import, Tidy, Transform, Visualize and Model Data. 1st ed. O’Reilly Media, Inc.


